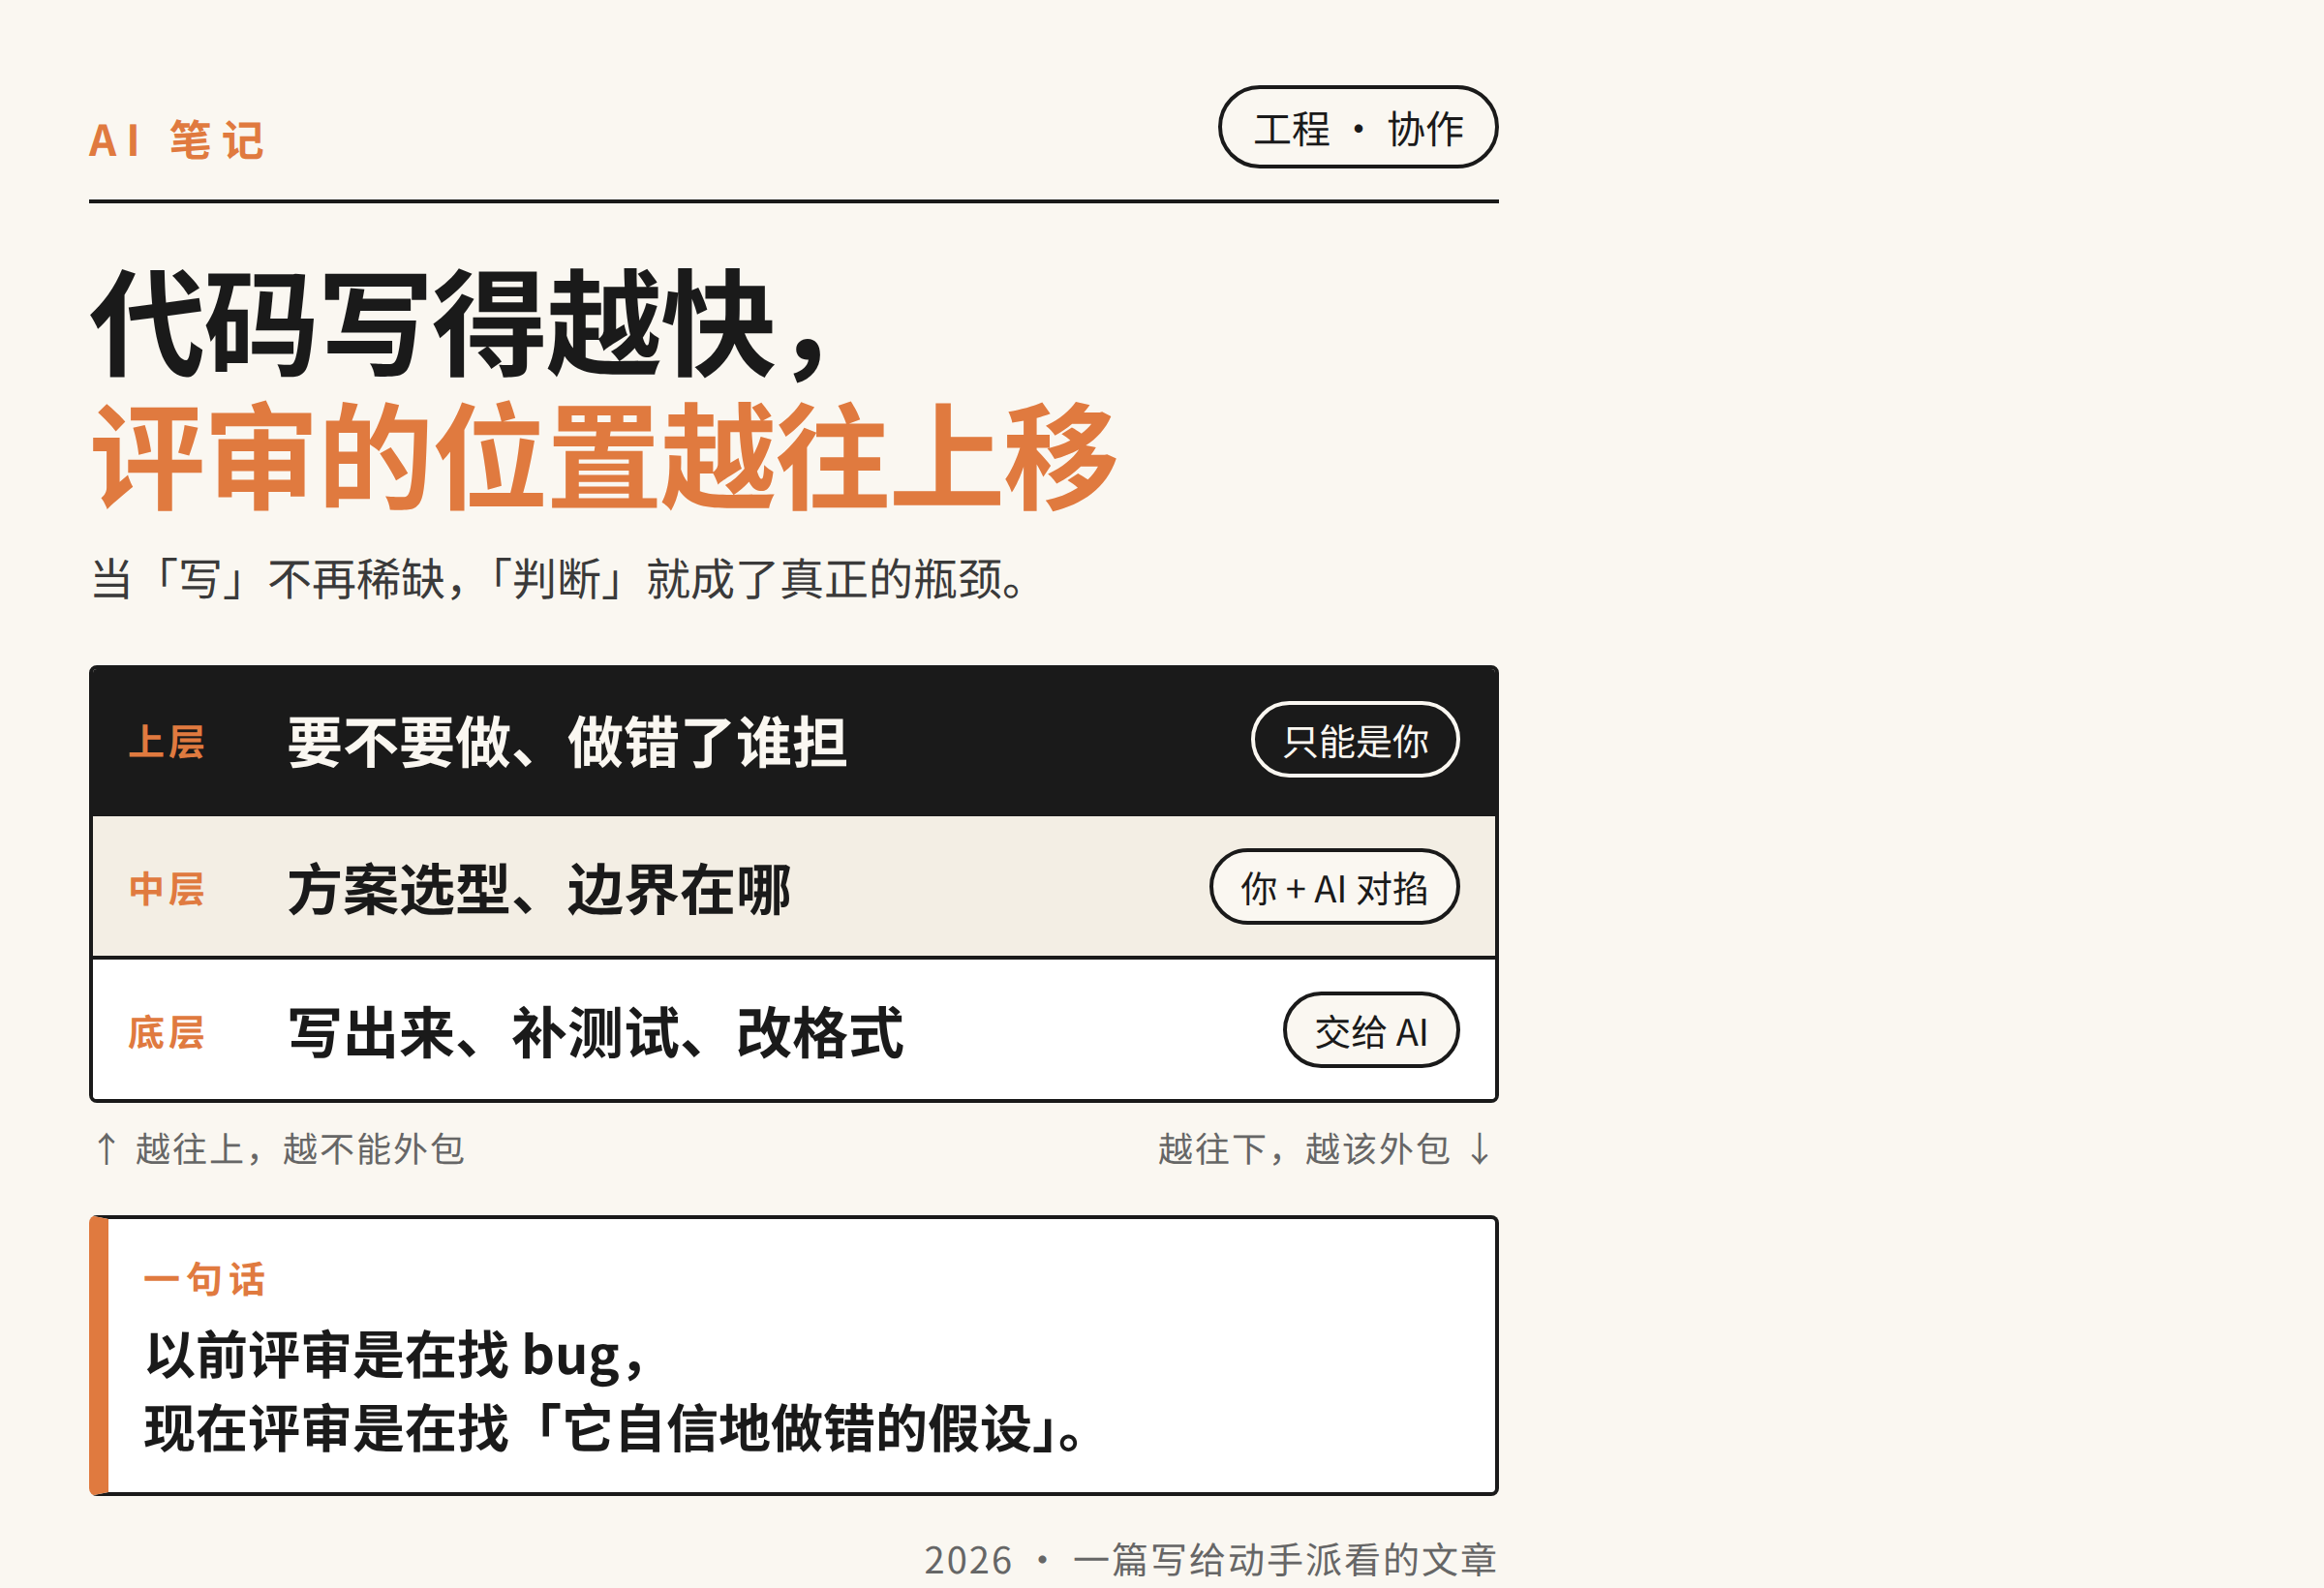
代码写得越快,评审的位置越往上移
这周我用同一个需求分别让三个模型写代码:一个不算复杂的「把 CSV 里的脏数据洗干净,再按地区汇总」。
三个都给了能跑的代码。
然后我花了半天时间,把这三份都改成了能进主干的东西。
这半天里,「写」的部分几乎没花时间,「判断」的部分花光了所有时间。
一、变快的是打字,不是思考
先说一个容易被忽略的事实:AI 提速的地方非常具体。
它快到让你不习惯的,是从想法到第一版可运行代码的那一段。以前你脑子里有个方案,要摸半小时 API、查两次文档、修几个拼写错误,才能看见一个能跑的雏形。现在这段路几乎没有摩擦。
但代码行数从来不是瓶颈。
真正吃掉工时的,是那些写的时候不需要思考、改的时候需要反复思考的东西:
- 这份数据里到底有哪些脏法?空格?全角?还是这列有时是数字有时是「暂无」?
- 汇总口径按什么来?地区名要不要合并「北京」和「北京市」?
- 出错的时候是抛异常、跳过这行,还是整批重来?
这几个问题,AI 都会给你一个答案。
问题是它给答案的时候,语气和你自己是完全一样的。
不会说「我猜」,不会标「这里需要确认」,就是很自然地写下去。等你在评审的时候发现口径理解错了,已经过去很久了。
二、AI 写得像对的,比写错更麻烦
我见过太多人把 AI 生成的东西当成「草稿」——意思是,反正细节我再改。
这个心态在以前是成立的,因为人写的草稿一眼能看出哪里心虚:注释写着 TODO,变量名含糊,函数长得离谱,某些地方明显是复制来的。
AI 生成的代码没有这些特征。
它命名规范,结构整齐,该有的异常处理一个不少,注释写得比大多数人都清楚。
所有「这个人可能没想清楚」的信号,全被磨平了。
于是评审的人失去了最有效的一条线索。
以前你扫一眼就知道该重点看哪,现在你得逐行读,并且每一行都要问一遍:这个假设成立吗?
这不是代码质量问题,而是证据质量问题。代码不再携带「作者当时的确定性程度」。
三、所以评审的位置,必须往上移
我现在的做法比较简单:不再把评审的资源平均分配,而是往上游挪。
具体是三层:
底层:写出来、补测试、改格式、写迁移脚本。
这一层全部交给 AI,我基本不看细节。反正结果可验证——测试跑不过、接口对不上、格式检查没过,机器会告诉我。
中层:方案选型、边界在哪、失败怎么退。
这一层我会让 AI 先给两三个方案,然后自己挑一个,再让它扮演反方,指出这个方案最可能死在哪里。它挑毛病的水平,明显高于它自己想方案的水平。
顶层:要不要做、做错了谁担。
这一层不外包。不是能力问题,是责任问题。
挪完之后我发现,评审会的时间结构变了。
以前大家围着 diff 看变量名、看缩进、看有没有多余的 import。现在这些都能自动过,会议直接跳到「为什么这个字段允许为空」「这个超时设 5 秒是从哪来的」。
评审从查格式,变成了查假设。
四、一个很土但有效的办法
说个具体操作。
我现在让 AI 写任何超过五十行的东西,都会在开头要求它先输出一段「我做了什么假设」。
格式大概是:
假设:
1. CSV 编码为 UTF-8,没有 BOM
2. 「暂无」「-」「N/A」都视为空值
3. 地区名按原样分组,不做标准化
就这三行,评审时的价值超过整个 diff。
因为它把这批代码里最脆弱的三个点提前摆到了桌面上。任何一个不成立,后面全是白忙。
AI 写这三行的时候很老实,因为它不需要维护面子。反而是人不愿意写——写了就等于承认自己没问清楚。
写在最后
回到那半天。
我把三份代码都读了一遍,最后选的那份不是因为写得最漂亮,而是因为它把「编码可能是 GBK」这个假设写在了最前面,并且留了一个开关。
另外两份代码更优雅,但它们默认了 UTF-8,而我的数据里有一半是 GBK。
这个差距,跟模型强不强没关系,跟它有没有把「不确定」说出来有关系。
所以我现在对 AI 写代码的判断标准很朴素:不看它写得多好,看它有没有告诉你它哪里不确定。
愿意说的,可以放心用。一句都不说的,写得再漂亮也要一行一行看。
代码写得越快,这件事越重要。