大模型压进笔记本:真正难的不是参数量
上周有人在群里发了一张图:一台 16G 内存的轻薄本,终端里正在跑一个 7B 的模型,速度显示 18 tokens/s。
底下一片「牛」。
我没说话。因为在同一台机器上,我也跑过。18 tokens/s 是真的,但那个模型回答「帮我看看这段代码有什么问题」时,给出的建议属于「听起来很有道理,细看全是废话」那一类。
能跑,和能用,中间隔着一整条河。
一、参数量的账,其实最好算
先算最简单的:显存或者内存够不够。
一个 7B 模型,FP16 要 14G 左右,16G 的机器勉强塞进去,但系统就没地方待了。所以第一步一定是量化。
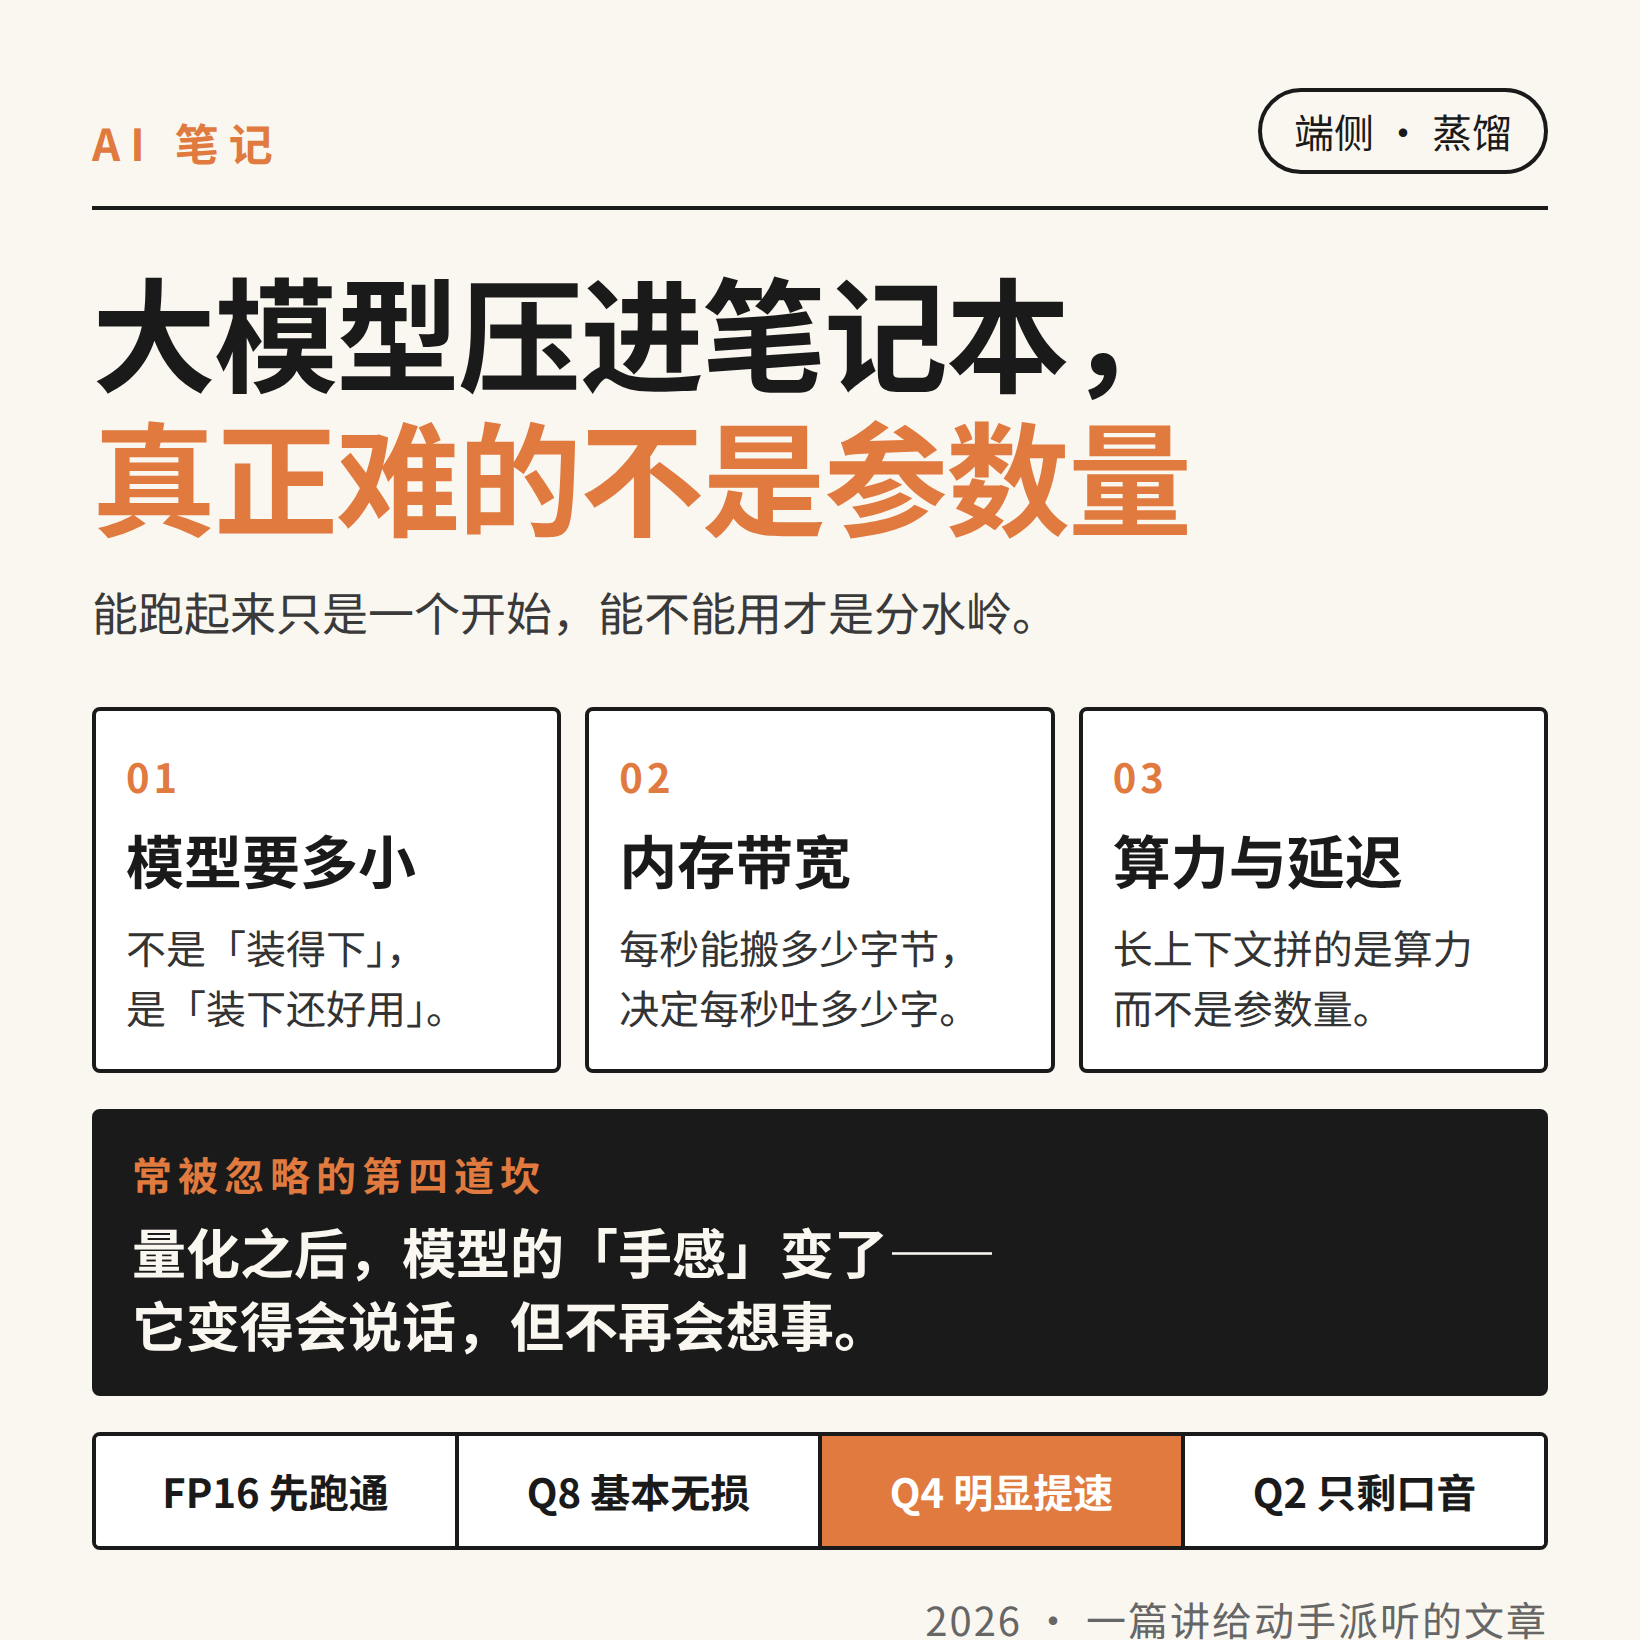
常见的档位是 Q8、Q6、Q4、Q2。粗暴理解:Q8 基本无损,Q4 掉一点,Q2 只剩口音。
我自己的观察是:Q4 是性价比的拐点。从 FP16 到 Q4,体积缩到四分之一,速度大概翻倍,而日常对话、改写、摘要这类任务,肉眼看不出差别。
再往下就不好说了。Q2 的模型还能说人话,但你让它做三步以上的推理,它会开始东拉西扯。不是变笨,是权重被压得太狠,原本那点「想一下再答」的能力被抹平了。
所以第一道坎不是「能不能装下」,是「装下之后还剩多少脑子」。
二、真正卡人的是内存带宽
这一条最反直觉。
很多人以为推理慢是算力不够,于是盯着显卡的 TFLOPS 看。但大模型生成文字这件事,本质上是一遍一遍把权重从内存搬进计算单元。
每吐一个 token,都要把模型整个读一遍。
所以每秒能吐多少字,约等于「内存带宽 ÷ 模型体积」。
举个例子:一台笔记本的内存带宽大概 100 GB/s,一个 Q4 量化的 7B 模型大约 4 GB。理论上限就是 25 tokens/s。17、18 的速度,已经是跑到理论值的七成,算是很好的实现了。
反过来,如果换成 13B 的 Q4,模型变 8 GB,理论上限掉到 12 tokens/s。你会发现再怎么优化代码、换推理框架,也就那么回事。
这时候拼的不是算法,是硬件。
也是为什么苹果那套统一内存跑本地模型体验不错——不是芯片多强,是内存带宽给得足。
三、长上下文是另一笔账
还有一笔账很容易被忽略。
上面说的「每吐一个字读一遍权重」,只在上下文很短的时候成立。当上下文涨到几万字,每生成一个 token,注意力机制还要把前面所有内容重新算一遍。
这部分开销跟上下文长度是平方关系。
所以你会遇到一种很怪的现象:同一个模型,问一句短话,飞快;贴进去一份两万字的文档再问,慢到想去泡杯茶。
这不是模型变了,是它每次开口之前,都要把整份文档再读一遍。
实际用的时候,我的建议是:别把长上下文当垃圾桶。与其一次塞十万字,不如先让模型做一轮摘要,或者用检索把相关段落挑出来。省下来的不只是时间,还有准确率——上下文太长,模型反而容易抓错重点。
四、还有一道没人提的坎
前三道都是工程问题,能靠算账解决。
第四道不是。
量化之后的模型,会变得「会说话,但不太会想事」。
它依然能接住你的话,语气自然,格式工整,甚至还会主动分点。但你让它做一件需要多步推导的事——比如从一段报错里定位根因,或者判断两个方案哪个更稳——它开始给你一些「看起来对」的答案。
这类错误最难发现,因为它的表达太流畅了。
我的应对办法很土:把本地模型当助手,不当顾问。
让它干那些「输出可验证」的活:改写、翻译、格式化、提取字段、写样板代码。这些任务对不对,你一眼能看出来。
需要判断、需要取舍、需要为结论负责的事,还是交给更大的模型,或者干脆自己来。
写在最后
回到开头那个 18 tokens/s。
它确实是个不错的数字。但数字只回答了「跑得动吗」,没回答「值得跑吗」。
我现在对本地模型的态度是:它不是一个缩小的云端模型,它是一个能力边界完全不同的东西。用对了场景,它安静、免费、不联网、随时待命,比云端舒服得多。
用错了场景,它就是一个说话很溜、但经常自信地胡说的人。
分辨这两者,比调参重要。