AI 为什么会忘事:聊聊上下文窗口
聊到第三十轮,它忽然问:「你刚才说的那个项目叫什么来着?」
不是它笨,是它的桌子就那么大。
一、窗口,就是一次能看见多少字
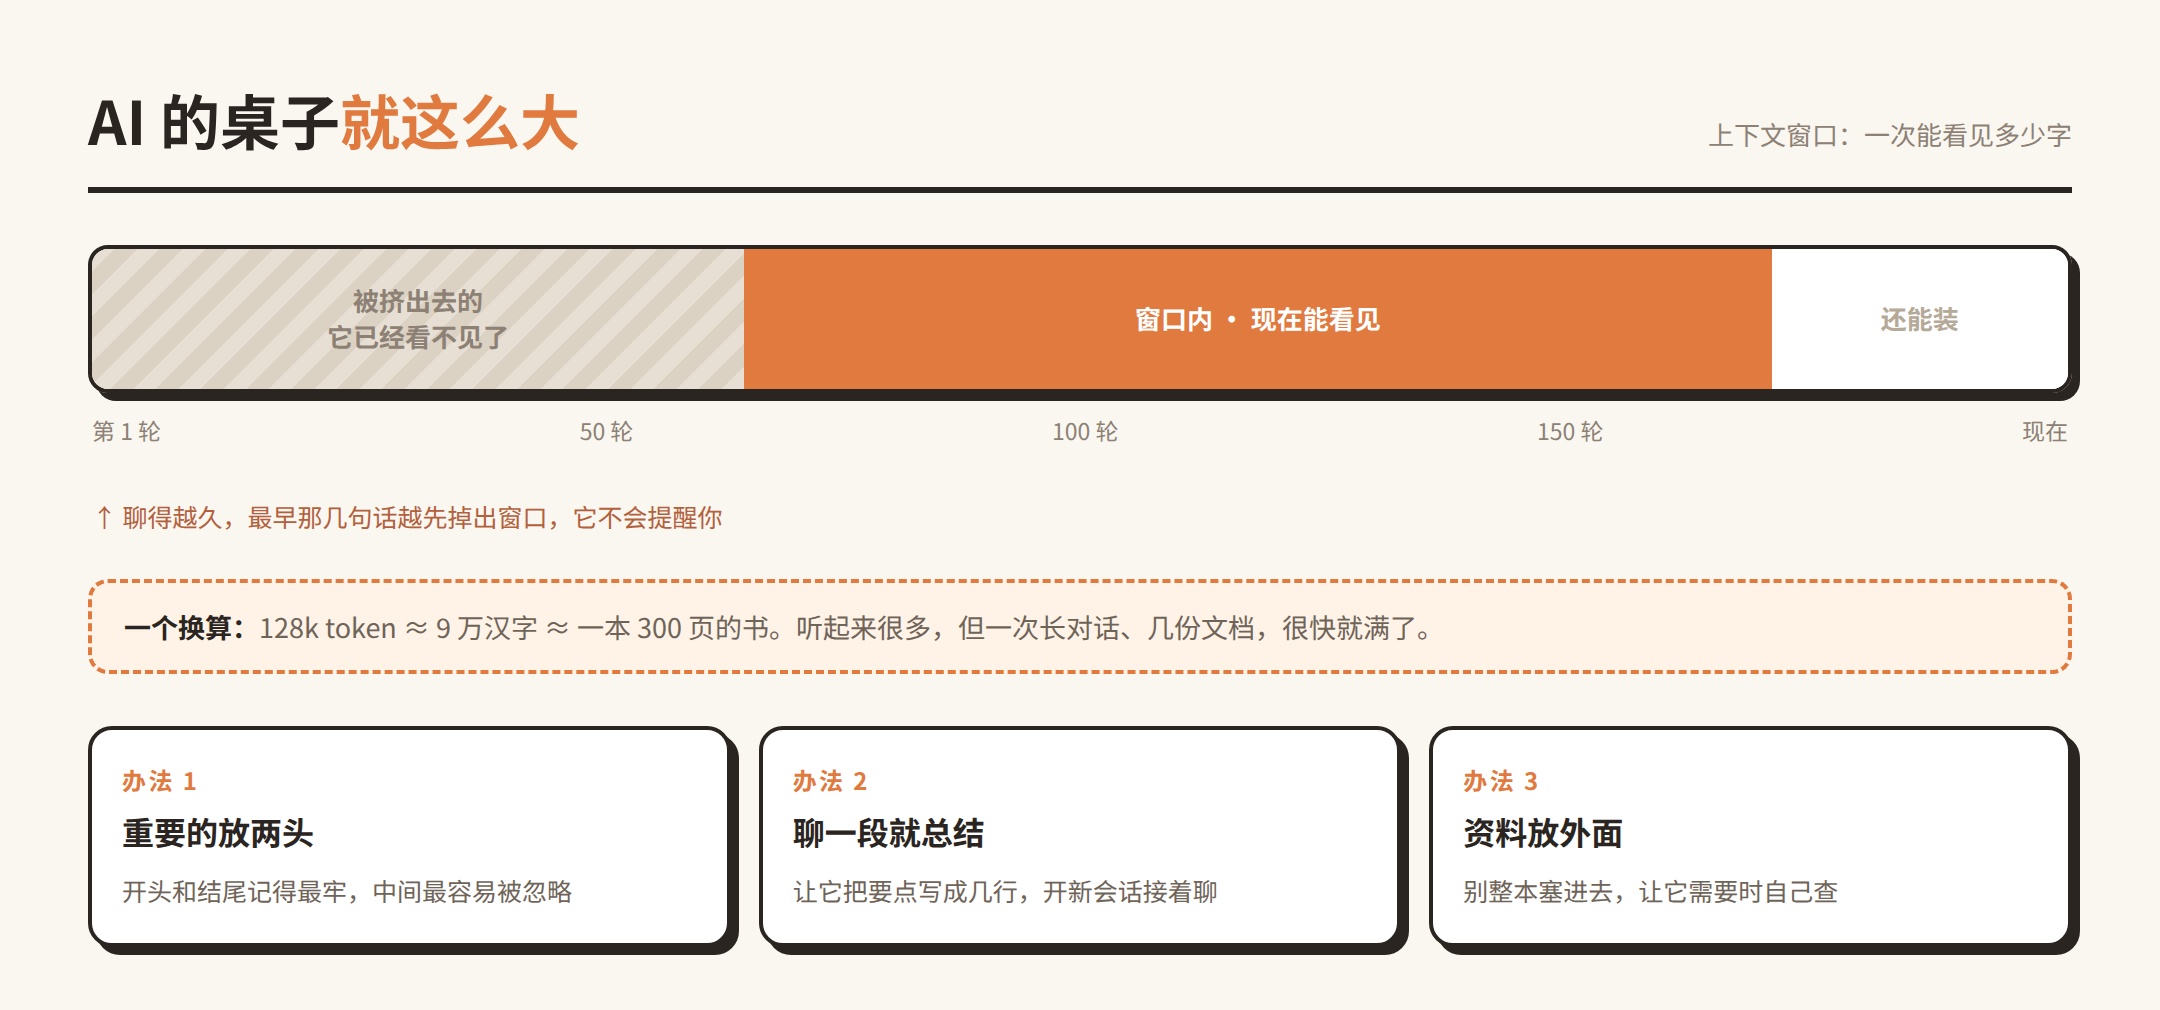
模型一次能读进去的内容有上限,这个上限叫上下文窗口,单位是 token,粗略算一个字到一个词。
现在常见的是 128k token,大约 9 万汉字,一本 300 页的书。
听起来很多。但一次长对话、几份文档、一堆代码,很快就满了。
二、它不是「记住」,是每次重读
这一点最容易误会。
它没有记忆。每次你发消息,它都把「系统提示 + 整个对话历史 + 你这句话」重新读一遍,然后接着往下写。
所以所谓「记得」,其实是「还没掉出窗口」。一旦掉出去,它就是个陌生人。
三、超出之后,会发生两件事
一是直接报错:超出最大长度,不让你发。
二是悄悄丢掉最早的:很多产品会自动截断,把最前面几轮扔掉,好让你继续聊。
第二种更麻烦,因为你不知道它从哪一句开始忘的。你以为它有上下文,其实那部分早就不在了。
四、为什么不能无限大
注意力机制要计算每个字和每个字之间的关系,长度翻一倍,计算量大约翻四倍。
再加上显存占用,长上下文的成本是平方级往上走的。
所以不是厂商小气,是物理账算不过来。
五、四个能立刻用上的办法
| 办法 | 怎么做 | 什么时候用 |
|---|---|---|
| 重要的放两头 | 关键背景写在第一条,或最后再强调一遍 | 长对话 |
| 聊一段就总结 | 让它把结论压成几行,开新会话接着聊 | 写长文、做长任务 |
| 资料放外面 | 别整本塞进去,让它需要时自己检索 | 文档问答 |
| 说具体名字 | 别用「那个东西」,直接说文件名叫什么 | 所有场景 |
第三条尤其重要:把 100 页文档塞满窗口,效果往往不如先让它读目录、再按需读章节。
有个现象叫「lost in the middle」:放在中间的信息最容易被忽略,开头和结尾反而记得牢。
六、一句话
它不是在跟你聊天,是在每次重新读一遍你们的聊天记录。
理解这一点,你就知道该怎么跟它说话了:重要的往前放,长了就总结,别指望它记住三个月前那句寒暄。